

Was nützen klare Informationsschutzregeln, wenn sie auf einen großen Teil der vorhandenen Dokumente noch gar nicht angewendet wurden?
Viele Unternehmen haben ihren Informationsschutz längst organisiert: Schutzbedarfsstufen sind definiert, Richtlinien etabliert und Sensitivity Labels eingeführt. Doch in SharePoint, OneDrive oder auf Fileservern liegen häufig große Mengen historisch gewachsener Dokumente, die nicht oder nur uneinheitlich klassifiziert sind.
Die nachträgliche manuelle Bearbeitung solcher Datenbestände ist kaum zu bewältigen. Gleichzeitig gewinnt die Frage nach dem Schutzbedarf vorhandener Informationen mit Microsoft Copilot und anderen KI-Anwendungen an Bedeutung.
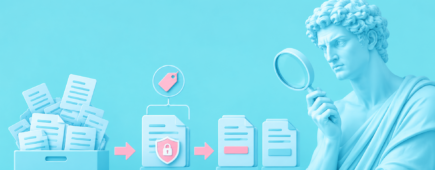
KI-gestützte Datenklassifizierung kann helfen, diese Lücke zu schließen – vorausgesetzt, sie orientiert sich an den fachlichen Regeln des Unternehmens und bleibt kontrollierbar.
Datenklassifizierung bedeutet, Informationen anhand definierter Kriterien wie Inhalt, Dokumenttyp und Schutzbedarf einzuordnen. Die technische Kennzeichnung, beispielsweise durch ein Sensitivity Label, macht diese Einstufung für entsprechende Informationsschutzprozesse nutzbar.
Bei neuen Dokumenten lässt sich die Klassifizierung in bestehende Arbeitsabläufe integrieren. Bei Alt- und Bestandsdaten ist die Ausgangslage deutlich komplexer.
Über Jahre hinweg wurden Dokumente unter unterschiedlichen Voraussetzungen erstellt und gespeichert. Nicht überall galten dieselben Vorgaben, und häufig fehlen Kennzeichnungen vollständig.
Drei Herausforderungen stehen dabei im Vordergrund:
Das Problem liegt also nicht zwangsläufig in fehlenden Schutzrichtlinien. Häufig fehlt ein praktikabler Weg, die bestehenden Regeln auf den tatsächlichen Datenbestand anzuwenden.
Anwendungen wie Microsoft Copilot können Informationen aus unterschiedlichen Quellen zusammenführen und für die Beantwortung von Fragen nutzen. Damit wird es für Unternehmen noch wichtiger, zu wissen, welche Informationen vertraulich, besonders schützenswert oder frei nutzbar sind.
Wichtig: Datenklassifizierung ersetzt keine Zugriffsberechtigungen. Sie ergänzt bestehende Sicherheitsmaßnahmen um die fachliche Bewertung der Informationen.
Bleiben große Teile des Datenbestands unklassifiziert oder uneinheitlich klassifiziert, fehlt eine wichtige Grundlage für die durchgängige Umsetzung von Informationsschutzregeln. Das betrifft Microsoft Copilot ebenso wie andere KI-Anwendungen und den kontrollierten Umgang mit Unternehmensinformationen insgesamt.
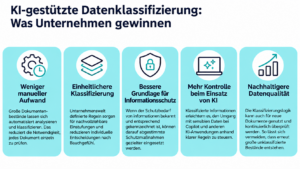
Das bedeutet nicht, dass eine KI eigenständig entscheidet, welche Informationen schützenswert sind.
Das Unternehmen definiert die Regeln auf Basis seiner bestehenden Schutzbedarfsfeststellung. Sie legt fest, welche Informations- und Dokumenttypen relevant sind und wie diese einzustufen sind.
Auf dieser Grundlage kann ein auf die unternehmensspezifischen Regeln abgestimmtes KI-Modell Dokumente analysieren und automatisiert klassifizieren. Besonders interessant ist das für fachliche Dokumenttypen, die mit generischen Erkennungsmechanismen nicht ausreichend zuverlässig zugeordnet werden können.
Nicht jedes Dokument ist eindeutig. Manche Inhalte lassen mehrere Klassifizierungen zu oder benötigen eine zusätzliche fachliche Bewertung.
Deshalb verbindet der sogenannte Human-in-the-Loop-Ansatz automatisierte Klassifizierung mit menschlicher Kontrolle:
So soll die KI den manuellen Aufwand reduzieren, ohne die fachliche Verantwortung zu übernehmen.
Auch Microsoft Purview spielt dabei eine wichtige Rolle. Ein ergänzender KI-Ansatz kann insbesondere dort unterstützen, wo kundenspezifische Dokumenttypen durch Standardmechanismen nicht ausreichend erkannt werden.
Er soll Purview nicht ersetzen, sondern die fachliche Klassifizierung verbessern und den Anschluss an bestehende Sensitivity-Label- und Governance-Prozesse ermöglichen.
Ob sich ein KI-gestützter Klassifizierungsansatz für einen bestimmten Datenbestand eignet, hängt von den vorhandenen Dokumenttypen, den fachlichen Regeln und der Qualität der Klassifizierungsvorschläge ab.
Deshalb ist ein begrenzter Pilot häufig der sinnvollere Einstieg als ein sofortiger unternehmensweiter Rollout.
Zunächst werden die relevanten Schutzbedarfsregeln und Dokumenttypen festgelegt. Anschließend wird ein geeigneter Datenbestand ausgewählt, gegebenenfalls mit anonymisierten oder geeigneten Demodaten.
Die KI erstellt Klassifizierungsvorschläge, die fachlich überprüft werden. Entscheidend ist dabei nicht nur, wie viele Dokumente automatisch zugeordnet werden, sondern auch, wie zuverlässig die Ergebnisse sind und welcher manuelle Prüfaufwand verbleibt.
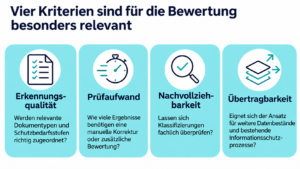
Die Ergebnisse schaffen eine Grundlage für die Entscheidung, ob und wie die Klassifizierung auf weitere Datenquellen ausgeweitet werden kann.
Perspektivisch lässt sich derselbe fachliche Rahmen auch für neue Dokumente nutzen. Klassifizierungsvorschläge können bereits während der Erstellung oder Bearbeitung unterstützen, damit nicht erneut große Bestände unklassifizierter oder uneinheitlich klassifizierter Dokumente entstehen.
Klare Richtlinien und definierte Schutzbedarfsstufen sind wichtige Voraussetzungen für den Informationsschutz. Ihre Wirkung bleibt jedoch begrenzt, wenn große Teile der vorhandenen Dokumente nicht entsprechend klassifiziert sind.
KI-gestützte Klassifizierung kann helfen, diese Lücke systematisch zu schließen. Mit einem abgegrenzten Pilot lässt sich prüfen, ob der Ansatz für den jeweiligen Datenbestand geeignet ist und wie er sich in bestehende Microsoft-Purview- und Governance-Strukturen integrieren lässt.
Wie lassen sich unklassifizierte Alt- und Bestandsdaten mithilfe von KI systematisch bearbeiten? In unserem Webinar am 27. November 2026 beschäftigen wir uns mit dieser Frage und den Herausforderungen bei der automatisierten Klassifizierung bestehender Dokumentenbestände.
Wir sind für Sie da.
Bei welchem Projekt oder welcher Herausforderung dürfen wir Sie unterstützen?
Wir sind gerne für Sie da.
HEIKO WESSELS

Wollen Sie immer up2date sein? Dann melden Sie sich jetzt zu unserem Newsletter an
Bleiben Sie auf dem Laufenden. Wir informieren Sie regelmäßig über aktuelle Trends und technologische Neuerungen sowie geplante Webinare und Events. Sie erhalten Einblick in interessante Kundenprojekte und werfen einen Blick hinter die Kulissen. Melden Sie sich jetzt an.